BUT3 · R502 Terminé
Supervision de conteneurs avec Prometheus et Grafana
J'ai construit dans Grafana un tableau de bord de supervision des conteneurs alimenté par Prometheus, avec des filtres par machine et par conteneur.
Contexte et objectif
L'Acte 1 du module est consacré au monitoring : rendre visible l'état d'un système d'information avant qu'un incident ne survienne. Le scénario place le système à superviser aux Kerguelen et le poste de supervision à La Réunion, à environ 3 300 km. L'objectif : voir dériver avant que cela ne lâche.
Ce que j'ai réalisé
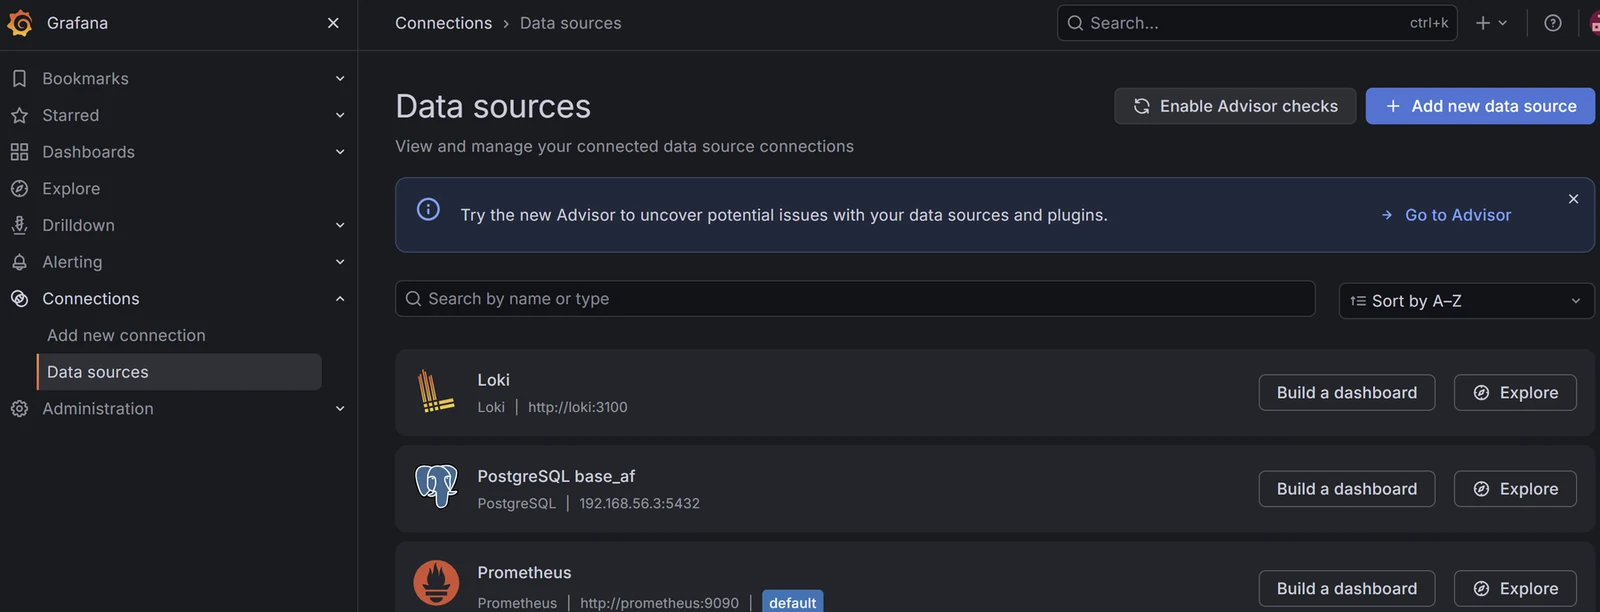
- J'ai déclaré la source de données Prometheus dans Grafana.
- J'ai construit un tableau de bord de supervision des conteneurs avec des variables de filtrage par machine et par conteneur.
- J'ai ajouté des indicateurs clés (valeurs instantanées) et des graphiques d'historique pour le processeur et la mémoire.
- J'ai répondu à dix questions de validation à l'aide de requêtes PromQL (plus gros consommateurs de mémoire, trafic réseau, entrées-sorties disque, corrélations).
- J'ai proposé des améliorations d'exploitation à partir de mes mesures.
Difficultés rencontrées et solutions
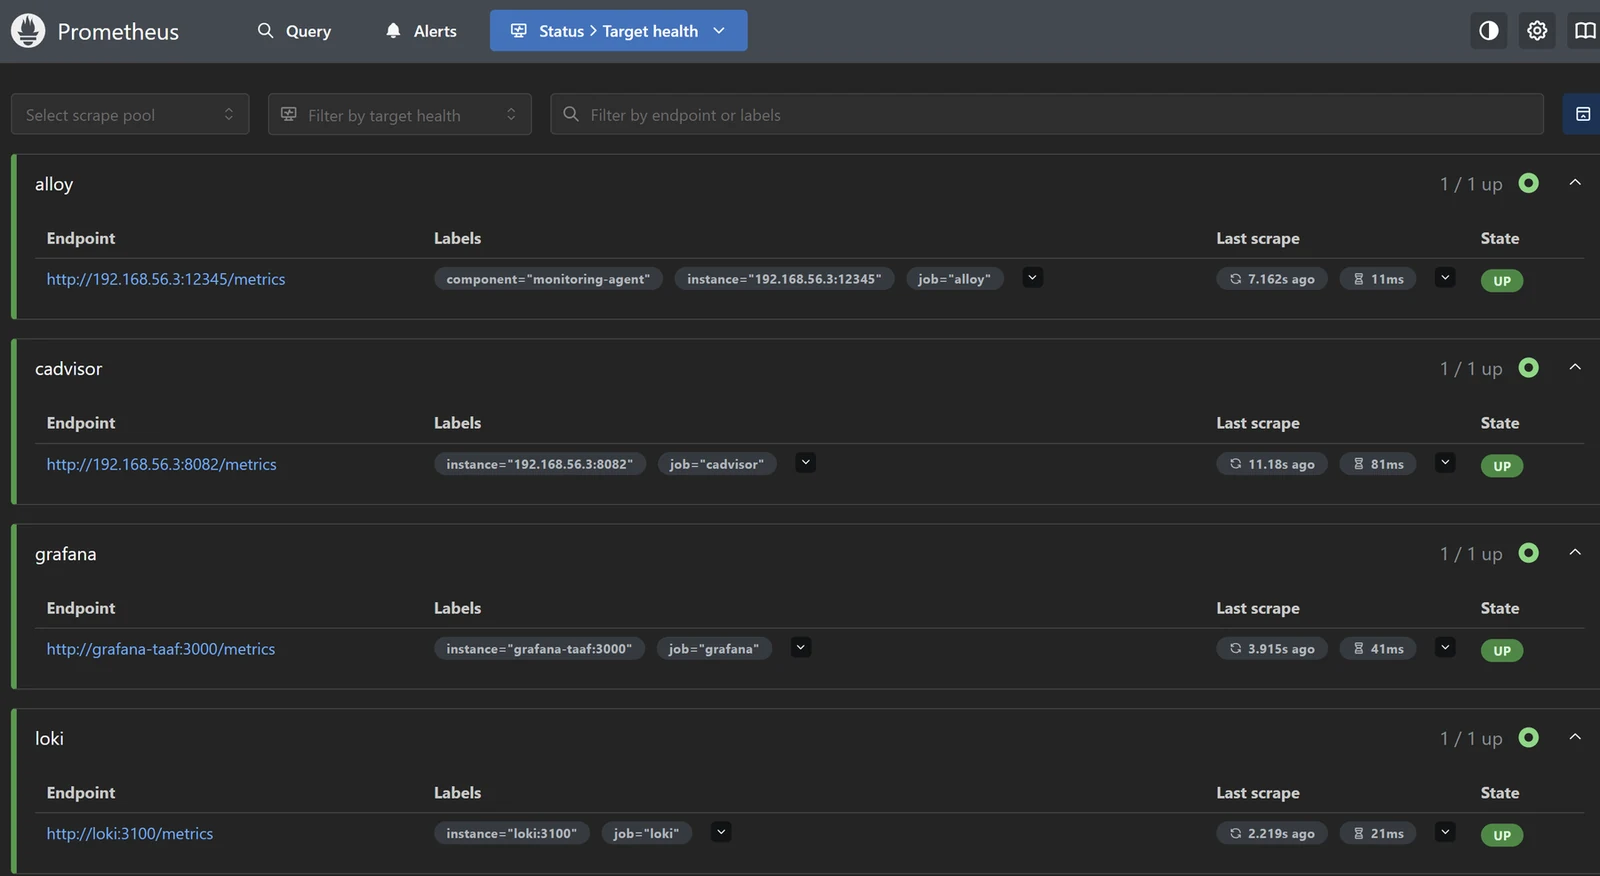
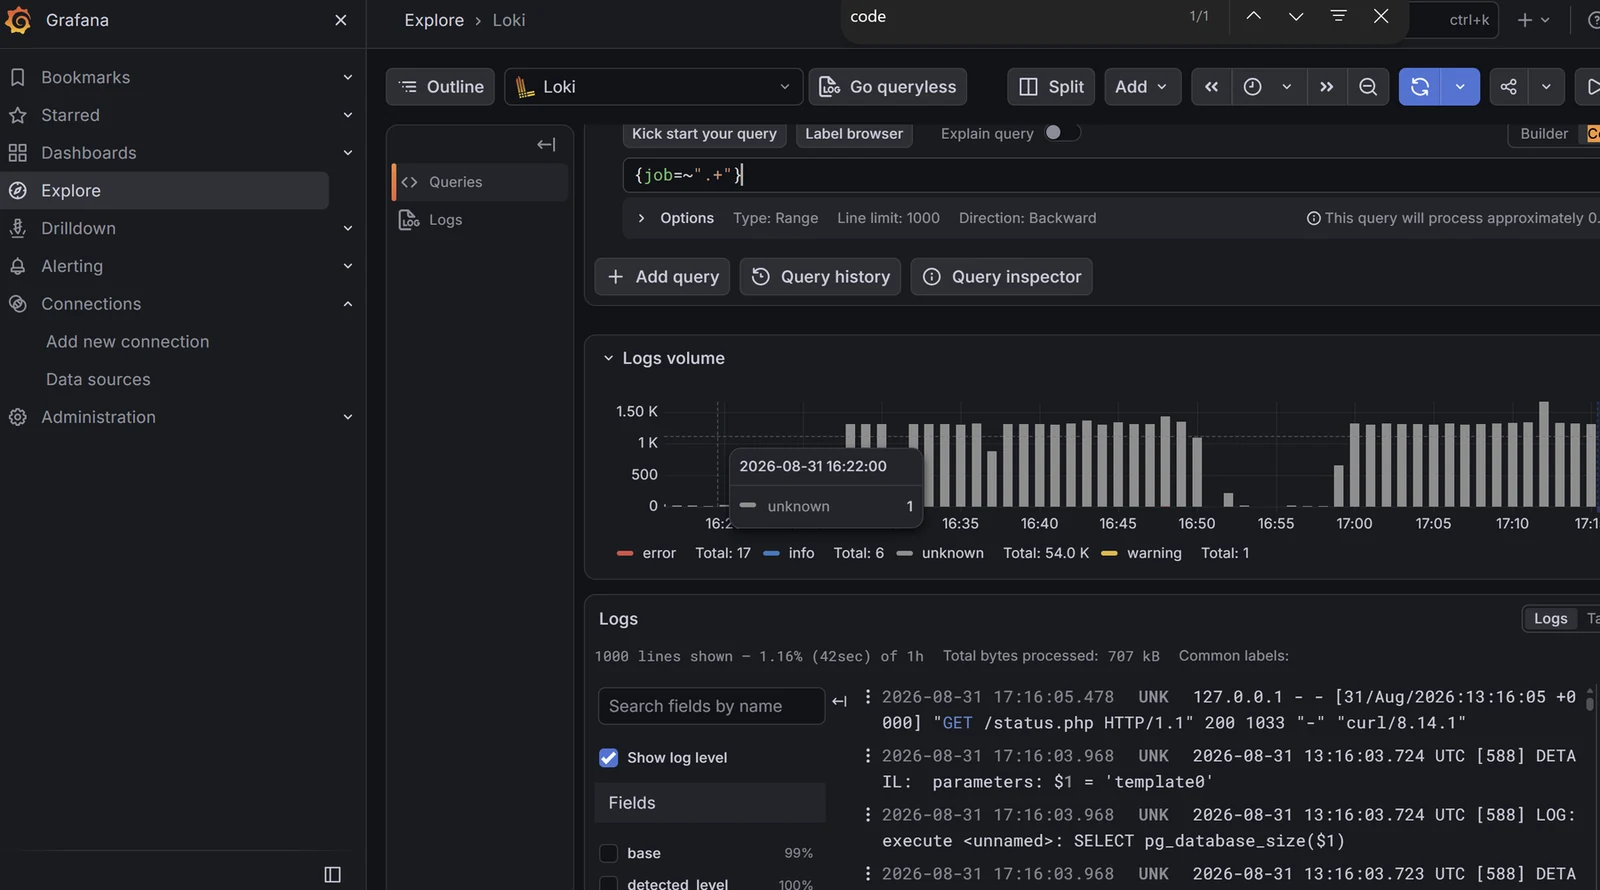
- Aucune requête ne fonctionnait : les métriques des conteneurs n'avaient plus de nom. En remontant à la source, j'ai trouvé la cause dans les journaux de l'exporter : la version récente de Docker utilise un nouveau magasin d'images que l'exporter ne sait pas lire. J'ai rétabli le magasin historique, sans perte de données.
- Désynchronisation des horloges entre les deux VM, qui faussait l'affichage.
- Confusion possible entre deux labels de noms proches dans les requêtes.
Résultats
- Huit conteneurs suivis en processeur et en mémoire, en instantané comme en historique.
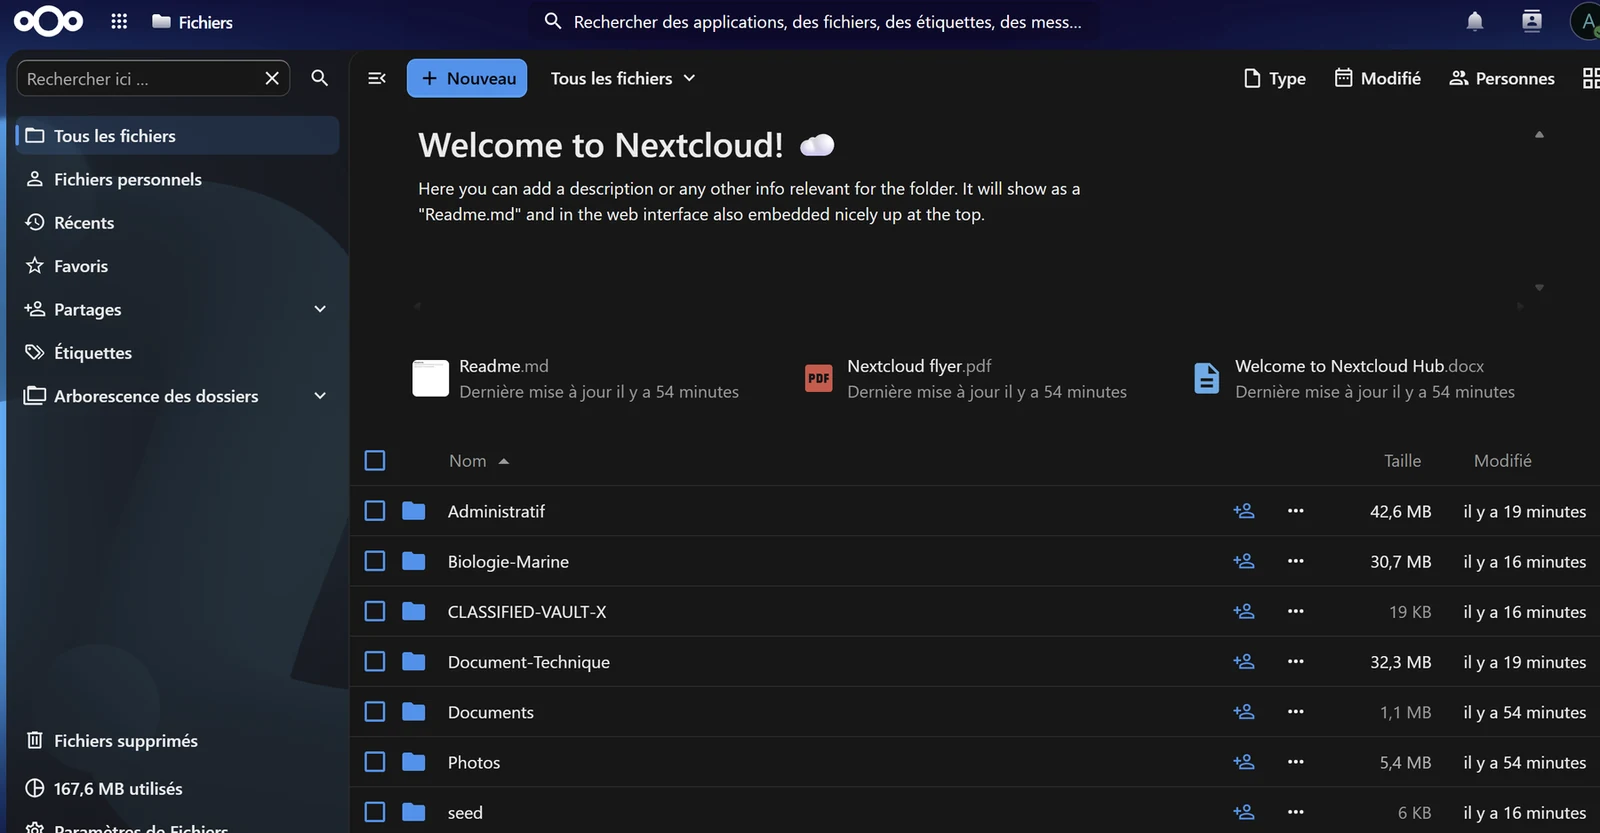
- Nextcloud représente à lui seul 24,40 % de la mémoire de la machine.
- L'agent de collecte de journaux arrive en tête des écritures disque, ce qui n'était pas attendu.
- Un décalage de trente secondes entre pic mémoire et pointe processeur de la base de données invalide l'interprétation la plus immédiate.
Ce que j'en retiens
La difficulté du monitoring ne réside pas dans l'écriture des requêtes. Deux constats d'exploitation ressortent : sans limite mémoire déclarée, l'infrastructure n'a aucune protection contre une fuite mémoire, et sans suivi des redémarrages, une classe entière de pannes reste invisible. Face à un panneau vide, je remonte à la source des données avant de toucher à la requête.
Technologies
- Grafana
- Prometheus
- PromQL
- cAdvisor
- Loki
- Alertmanager
- Docker
- Docker Compose
- Nextcloud
- PostgreSQL
En images